
Embeddings: o que são e como funcionam
Entenda o que são embeddings, como a IA transforma texto em vetores numéricos e por que essa técnica é a base de busca semântica e RAG.
Resumo rápido
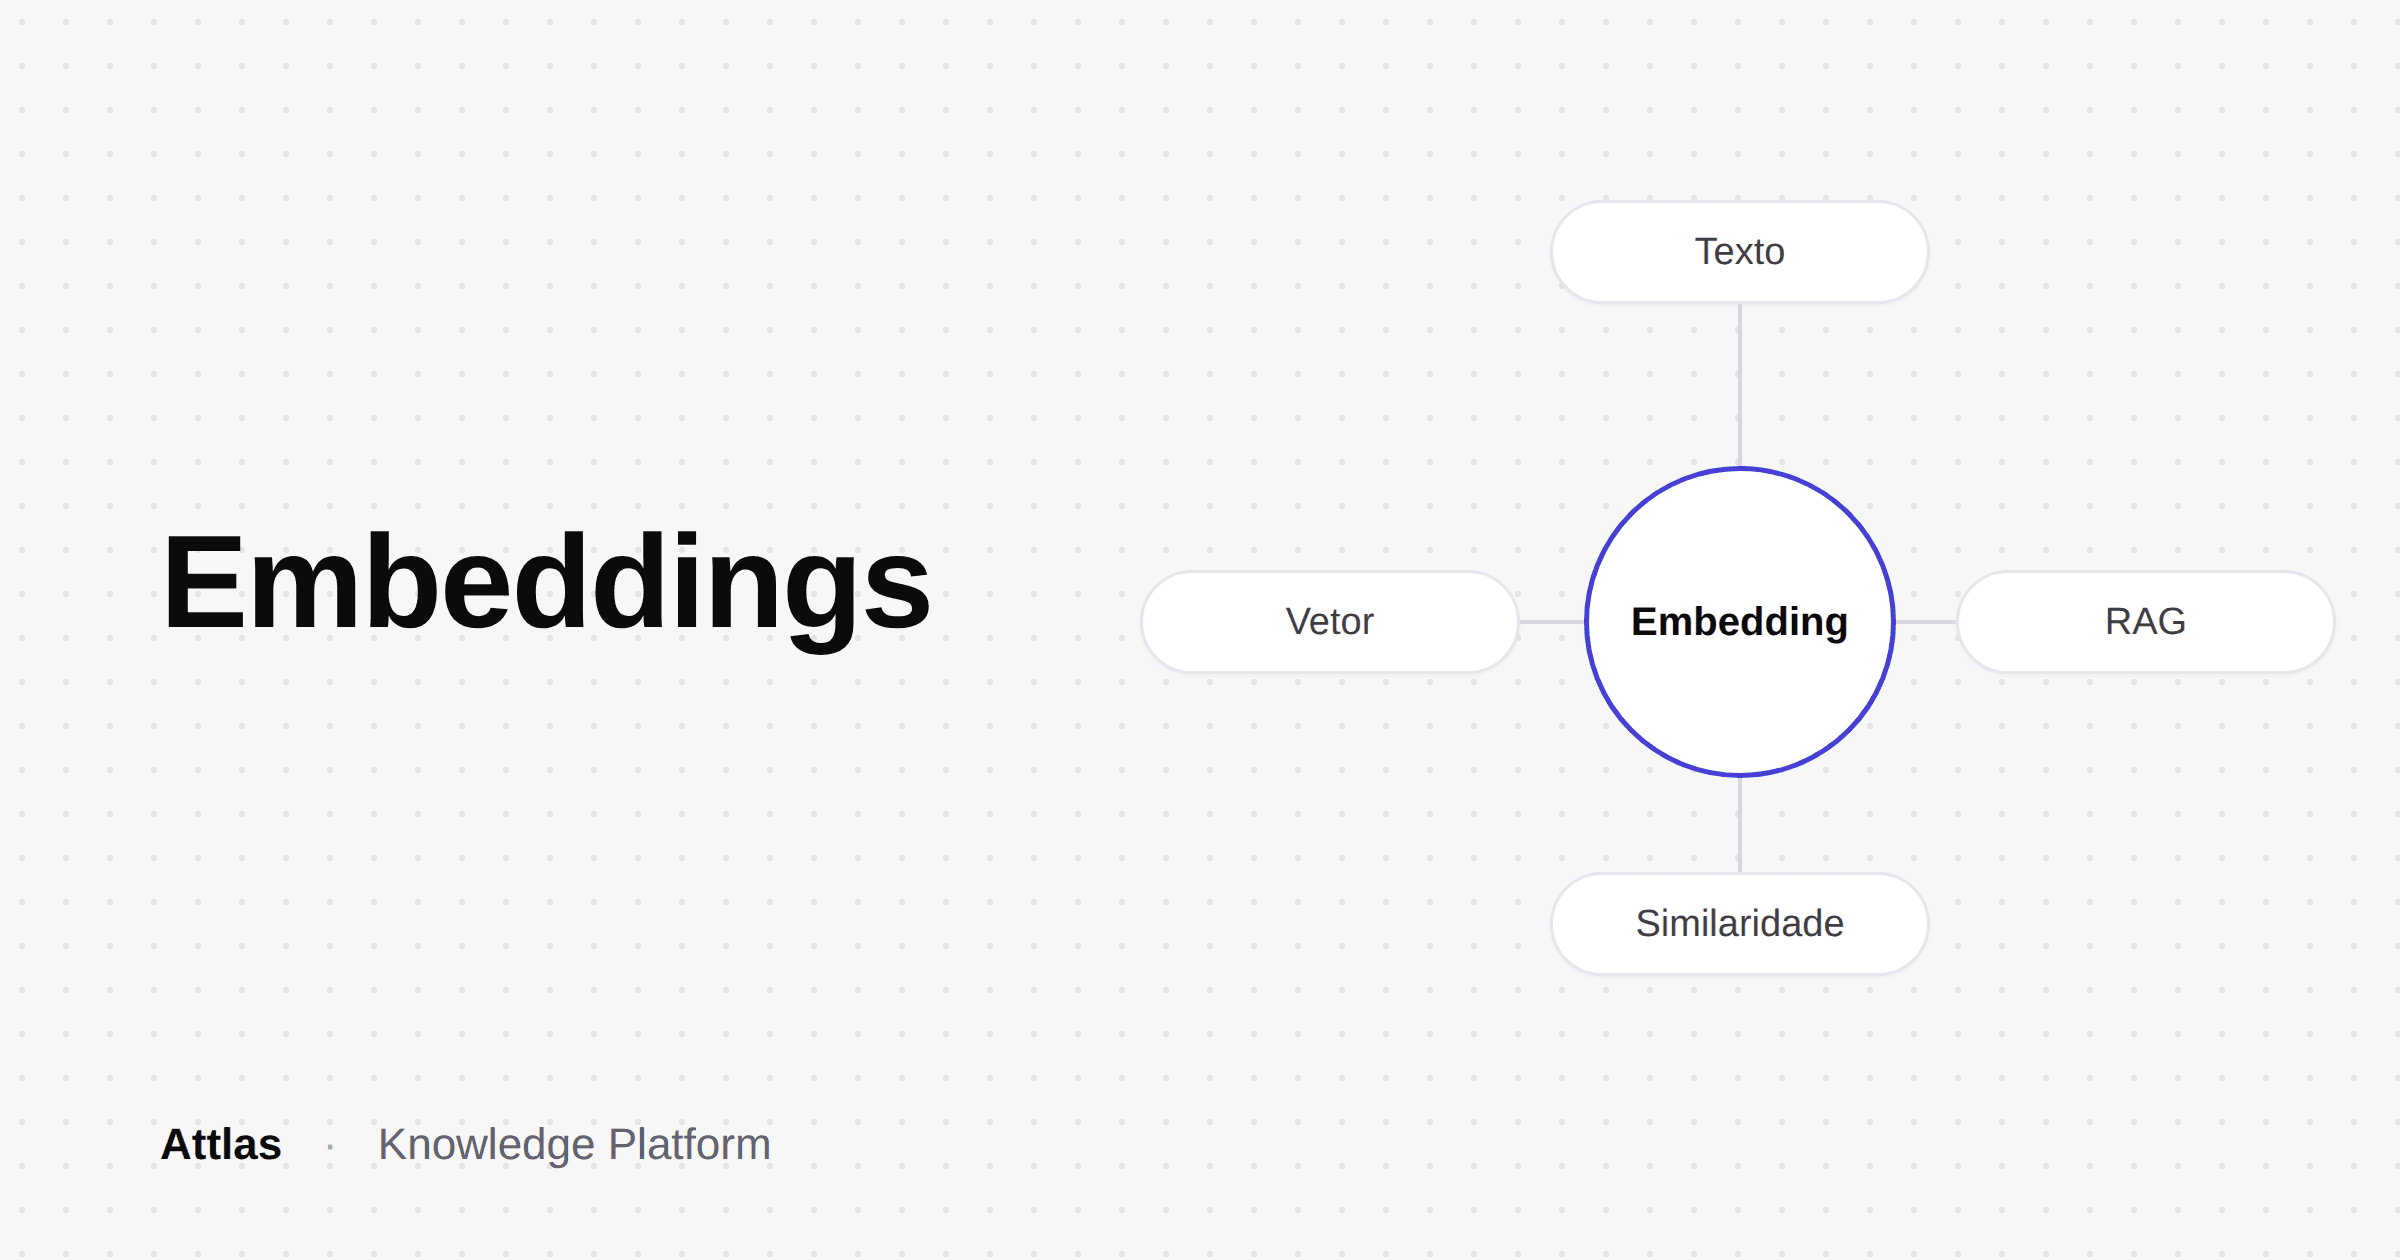
- Embeddings são vetores numéricos que representam o significado de um texto, imagem ou áudio.
- Conteúdos com significado parecido geram vetores próximos; conteúdos diferentes geram vetores distantes.
- São a base técnica de busca semântica, RAG, recomendação e classificação por similaridade.
- Diferem de tokens: tokens dividem o texto para processamento, embeddings representam seu significado.
Embeddings são a forma que uma LLM usa para representar palavras, frases ou imagens como listas de números, chamadas de vetores. Essa representação numérica captura o significado do conteúdo, de um jeito que permite comparar o quanto duas coisas são parecidas fazendo contas matemáticas, em vez de comparar o texto literal.
Este guia explica o que são embeddings, como eles são gerados, por que são a base técnica por trás de busca semântica e RAG, e como se diferenciam de outros conceitos como tokens.
O que são embeddings
Um embedding é um vetor, uma lista de números decimais, que representa o significado de um pedaço de texto, imagem ou áudio em um espaço matemático de muitas dimensões (tipicamente entre algumas centenas e alguns milhares de números). Conteúdos com significados parecidos geram vetores próximos nesse espaço, e conteúdos com significados diferentes geram vetores distantes.
Por exemplo, os embeddings das palavras "cachorro" e "cão" ficam próximos entre si, porque têm significado semelhante, enquanto o embedding da palavra "parafuso" fica bem mais distante dos dois. O modelo aprende essa organização durante o treinamento, observando como palavras e frases aparecem em contextos parecidos.
Como os embeddings são gerados
Um modelo de embedding recebe um texto de entrada e devolve um vetor de números como saída. Esse processo é determinístico: o mesmo texto sempre gera o mesmo vetor pelo mesmo modelo. Modelos diferentes produzem vetores diferentes entre si, então embeddings gerados por modelos distintos não costumam ser comparáveis diretamente.
Depois de gerados, os vetores costumam ser guardados em um banco de dados especializado (um banco vetorial), que permite buscar rapidamente quais vetores estão mais próximos de um vetor de consulta, mesmo em coleções com milhões de itens.
Para que embeddings são usados
- Busca semântica: encontrar documentos relevantes para uma pergunta mesmo quando nenhuma palavra da pergunta aparece literalmente no texto.
- RAG: a etapa de busca em um sistema de RAG normalmente usa embeddings para localizar os trechos mais relevantes de uma base de conhecimento.
- Recomendação: sugerir itens parecidos com base na proximidade dos seus embeddings.
- Classificação e agrupamento: organizar grandes volumes de texto por similaridade, sem precisar de categorias definidas manualmente.
Embeddings vs tokens
Os dois conceitos aparecem juntos, mas resolvem problemas diferentes. Tokens são os pedaços em que um texto é dividido para que uma LLM consiga processá-lo; eles medem quantidade e custo. Embeddings são a representação numérica de significado gerada a partir de um texto (que pode ter vários tokens); eles medem similaridade. Um texto é primeiro dividido em tokens, e o modelo então usa esses tokens para calcular o embedding correspondente.
Como a similaridade é medida
A forma mais comum de comparar dois embeddings é a similaridade de cosseno, uma medida que indica o quanto dois vetores apontam na mesma direção, independente do seu tamanho. Quanto mais próximo de 1, mais parecido é o significado dos conteúdos originais; quanto mais próximo de 0 ou negativo, mais diferentes eles são.
Perguntas frequentes
Embeddings são a mesma coisa que RAG?
Não. Embeddings são a técnica de representação numérica usada dentro de um sistema de RAG para localizar informação relevante. RAG é o processo mais amplo de buscar contexto externo e incluir na context engineering antes de gerar uma resposta.
Preciso treinar meu próprio modelo de embedding?
Na maioria dos casos não. Existem modelos de embedding já treinados e prontos para uso via API, que funcionam bem para busca semântica e RAG sem exigir treinamento adicional.
Embeddings mudam se eu rodar o mesmo texto duas vezes?
Não, para o mesmo modelo. Gerar o embedding de um texto é um processo determinístico: o mesmo texto sempre produz o mesmo vetor quando processado pelo mesmo modelo de embedding.
Conclusão
Embeddings transformam texto, imagem ou áudio em números que capturam significado, permitindo que sistemas de IA comparem conteúdos por similaridade em vez de correspondência exata de palavras. Essa técnica é a base silenciosa por trás de busca semântica, recomendação e da etapa de recuperação em qualquer sistema de RAG.
Leve contexto ao time e aos agentes
Base viva, wiki, chat e artefatos — e o mesmo conhecimento exposto via MCP.