
O que é uma LLM: como funciona e quais os limites
Entenda o que é uma LLM (modelo de linguagem grande), como ela aprende a prever texto, por que isso basta para parecer raciocinar e quais são seus principais limites.
Resumo rápido
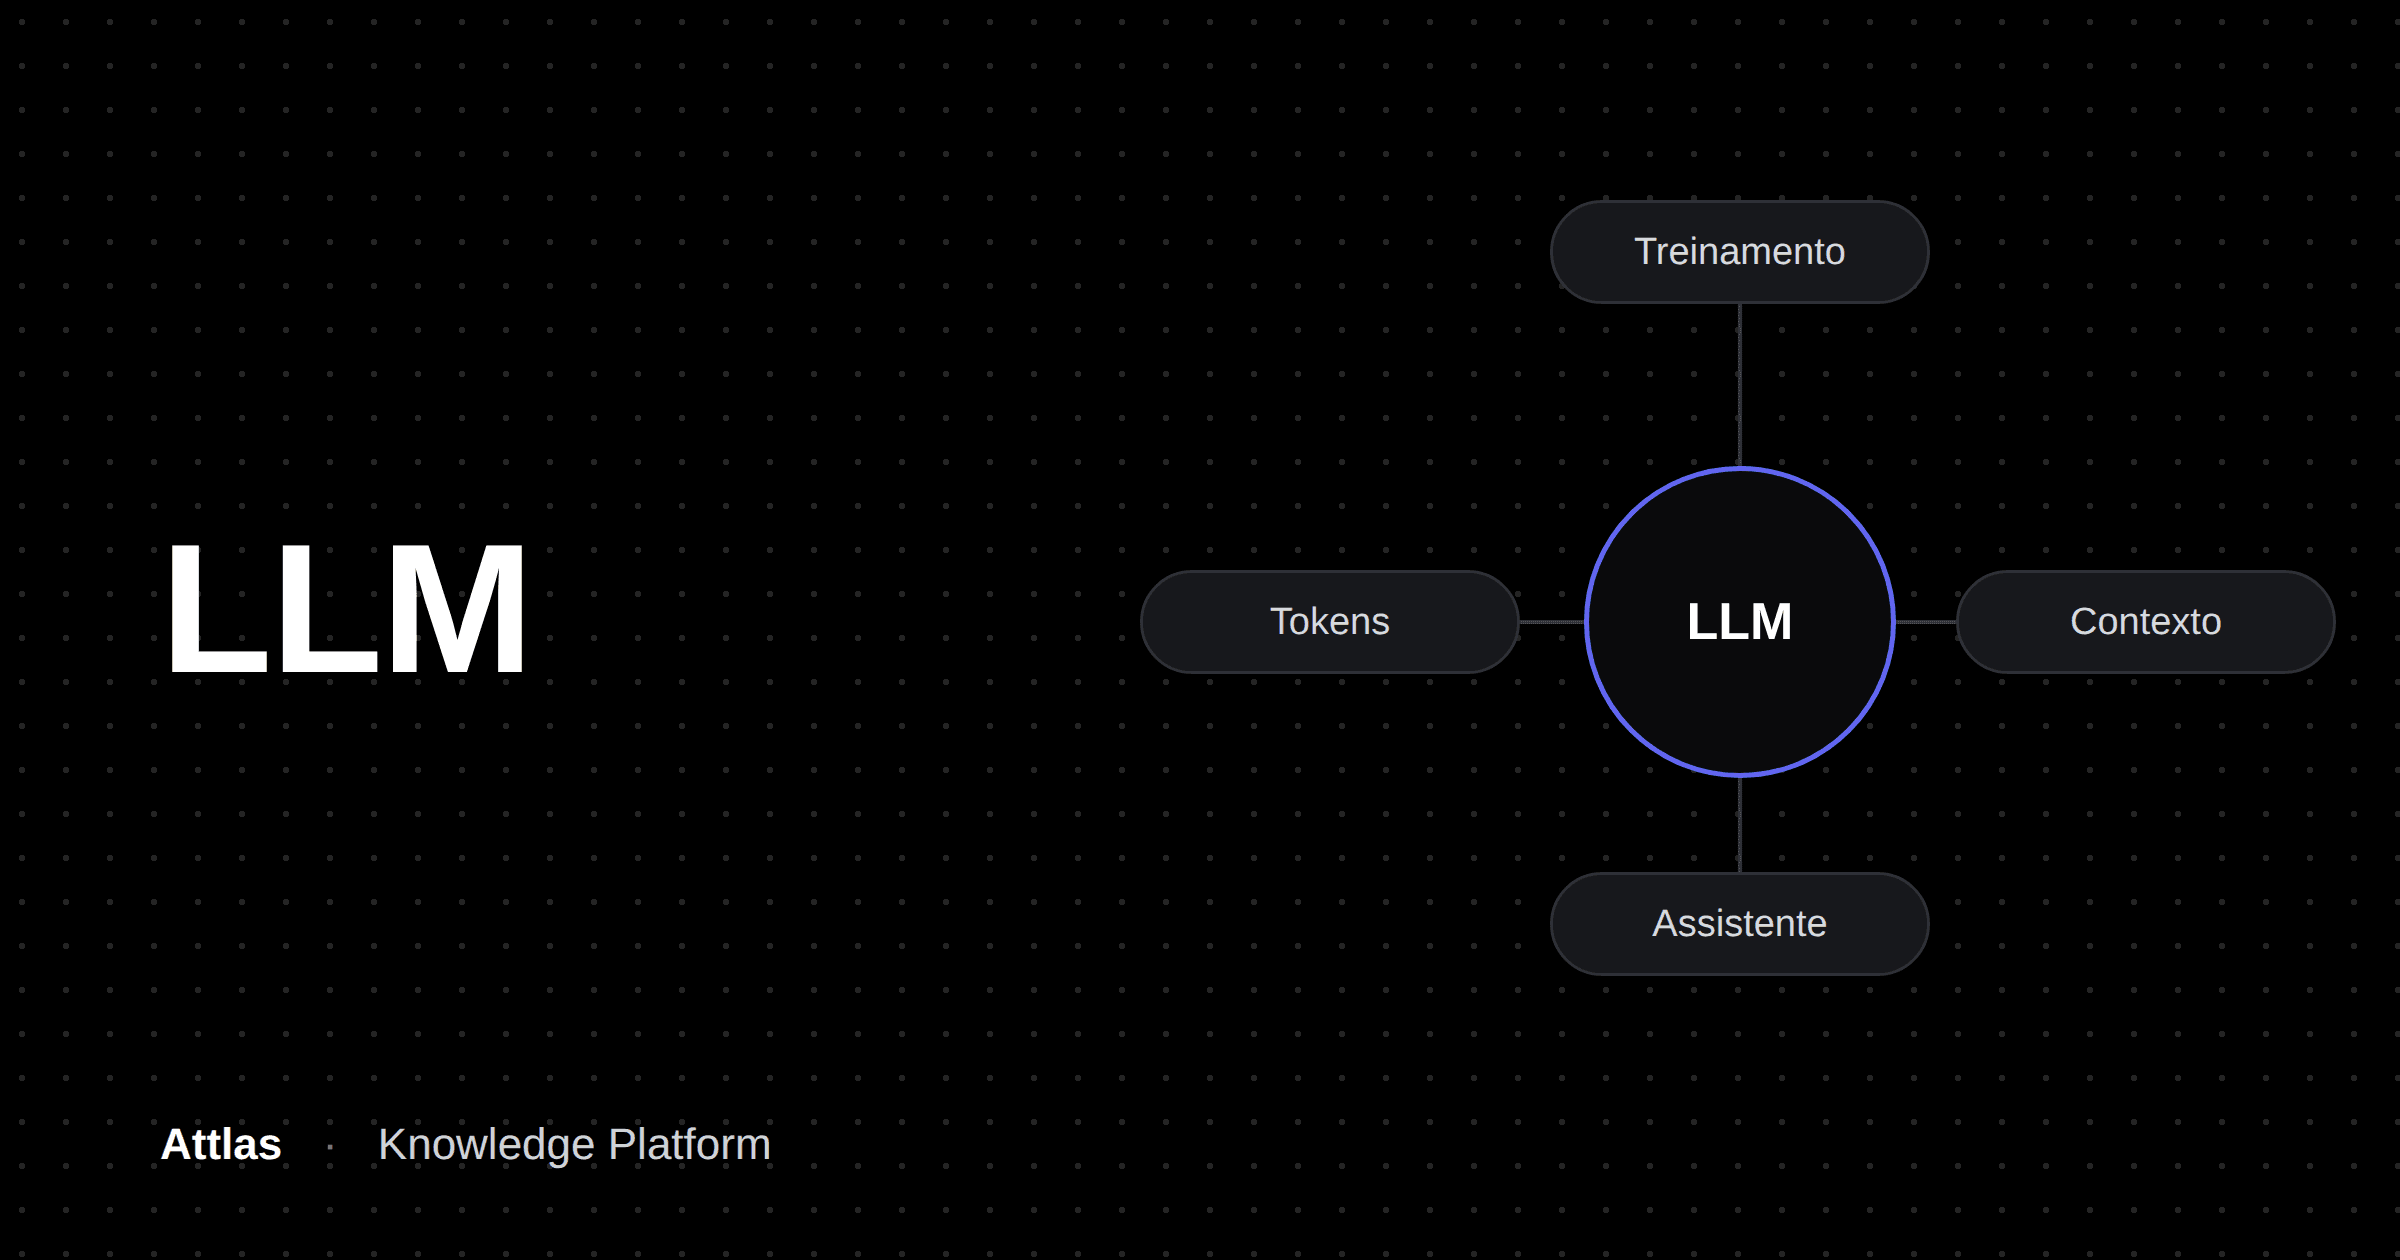
- LLM (Large Language Model) é um modelo treinado com uma quantidade enorme de texto para prever qual token vem a seguir numa sequência.
- O treinamento tem duas etapas: pré-treinamento (prever o próximo token em texto bruto) e ajuste fino, que ensina o modelo a seguir instruções e se comportar como assistente.
- Os principais limites são a janela de contexto, o conhecimento congelado na data do treinamento e a tendência a alucinar quando falta informação.
- A LLM é o motor por trás de assistentes e agentes de IA, não o produto final: o mesmo modelo pode virar um chatbot simples ou um agente autônomo, dependendo do que é construído em cima dele.
Uma LLM (Large Language Model, ou modelo de linguagem grande) é um sistema treinado com uma quantidade enorme de texto para prever qual token vem a seguir numa sequência. Não é um banco de dados de respostas prontas: é um modelo estatístico que aprendeu padrões de linguagem em uma escala tão grande que consegue produzir texto coerente, responder perguntas e seguir instruções.
Praticamente todo assistente de IA que você usa hoje, do chat de atendimento ao copiloto de código, tem uma LLM por trás. Este guia explica o que é essa peça central, como ela aprende e por que "prever o próximo token" é suficiente para produzir respostas que parecem raciocinar.
O que é uma LLM
LLM é a sigla para Large Language Model, um tipo de modelo de inteligência artificial treinado para entender e gerar linguagem natural. "Grande" se refere tanto ao volume de texto usado no treinamento quanto ao número de parâmetros do modelo, os valores internos ajustados durante o aprendizado, que hoje chegam à casa dos bilhões.
O resultado desse treinamento é um modelo capaz de continuar qualquer texto de forma coerente: dado um começo de frase, ele estima qual é o próximo trecho mais provável, e repete esse processo até formar uma resposta inteira.
Como uma LLM aprende
O treinamento de uma LLM costuma passar por duas etapas principais:
- Pré-treinamento, em que o modelo lê uma quantidade massiva de texto (livros, sites, código) e ajusta seus parâmetros repetidamente tentando prever o próximo token de cada trecho, sem qualquer supervisão humana direta sobre o conteúdo.
- Ajuste fino (fine-tuning), em que o modelo é refinado com exemplos de perguntas e respostas de qualidade, muitas vezes revisados por humanos, para que ele siga instruções e se comporte como um assistente, e não apenas complete texto de qualquer jeito.
É esse segundo passo que transforma um modelo que só "continua texto" em algo que responde perguntas, segue instruções e mantém uma conversa.
Prever o próximo token é suficiente para parecer raciocinar?
Surpreendentemente, sim, boa parte do tempo. Para prever bem o próximo token de um texto complexo, o modelo precisa capturar regularidades profundas da linguagem, do raciocínio lógico e até de conhecimento factual, porque essas regularidades ajudam a acertar a previsão. Não existe um módulo separado de "raciocínio" dentro da LLM: a capacidade de parecer raciocinar emerge do próprio processo de prever texto com muita precisão.
Isso também explica os limites do modelo: quando ele erra ou "alucina", não é uma falha de lógica isolada, é a previsão de token mais provável falhando em corresponder a um fato real.
Os limites de uma LLM
Três limites explicam boa parte do comportamento que se observa no dia a dia:
- Janela de contexto: uma LLM só considera uma quantidade limitada de texto de cada vez, medida em tokens. Fora dessa janela, a informação simplesmente não está disponível para a resposta.
- Conhecimento congelado no treinamento, já que o modelo só sabe o que existia nos dados até a data de corte do treinamento, a menos que receba informação adicional na própria conversa.
- Alucinação, a tendência de gerar uma resposta plausível, mas incorreta, quando o modelo não tem informação suficiente para responder com precisão.
É justamente para reduzir esses limites que técnicas como RAG existem: em vez de depender só do que o modelo memorizou no treinamento, elas buscam informação atualizada e específica para incluir na resposta.
LLM é o mesmo que assistente ou agente de IA?
Não. A LLM é o motor, o modelo que gera texto. Um assistente de IA ou um agente de IA é construído em cima de uma LLM, adicionando instruções, ferramentas e regras de comportamento. A mesma LLM pode servir de base para um chatbot simples ou para um agente autônomo, dependendo de como ela é usada e do que é conectado a ela.
Perguntas frequentes
LLM e IA generativa são sinônimos?
Não exatamente. IA generativa é um termo mais amplo, que inclui geração de imagem, áudio e vídeo. LLM se refere especificamente aos modelos que trabalham com linguagem, texto e código.
Toda LLM funciona da mesma forma?
O princípio de prever o próximo token é comum à maioria, mas cada família de modelo (GPT, Claude, Gemini etc.) usa arquitetura, dados de treinamento e processo de ajuste fino diferentes, o que gera respostas com estilo e qualidade distintos.
Uma LLM tem memória entre conversas?
Por padrão, não. Cada conversa começa sem lembrança das anteriores, a menos que a aplicação ao redor da LLM implemente algum sistema separado de memória de longo prazo.
Conclusão
Uma LLM é, no fundo, um modelo que aprendeu a prever texto com uma precisão impressionante depois de treinar com uma quantidade colossal de linguagem. Entender esse princípio simples (prever o próximo token) ajuda a entender tanto a capacidade quanto os limites de qualquer assistente ou agente de IA construído em cima dela.
Leve contexto ao time e aos agentes
Base viva, wiki, chat e artefatos — e o mesmo conhecimento exposto via MCP.