
O que é RAG: como funciona a busca aumentada por IA
Entenda o que é RAG (Retrieval-Augmented Generation), como funciona a busca e geração de resposta, e a diferença entre RAG, janela de contexto e fine-tuning.
Resumo rápido
- RAG (Retrieval-Augmented Generation) faz um modelo de IA buscar trechos relevantes numa base de conhecimento antes de responder, em vez de confiar só no que aprendeu no treinamento.
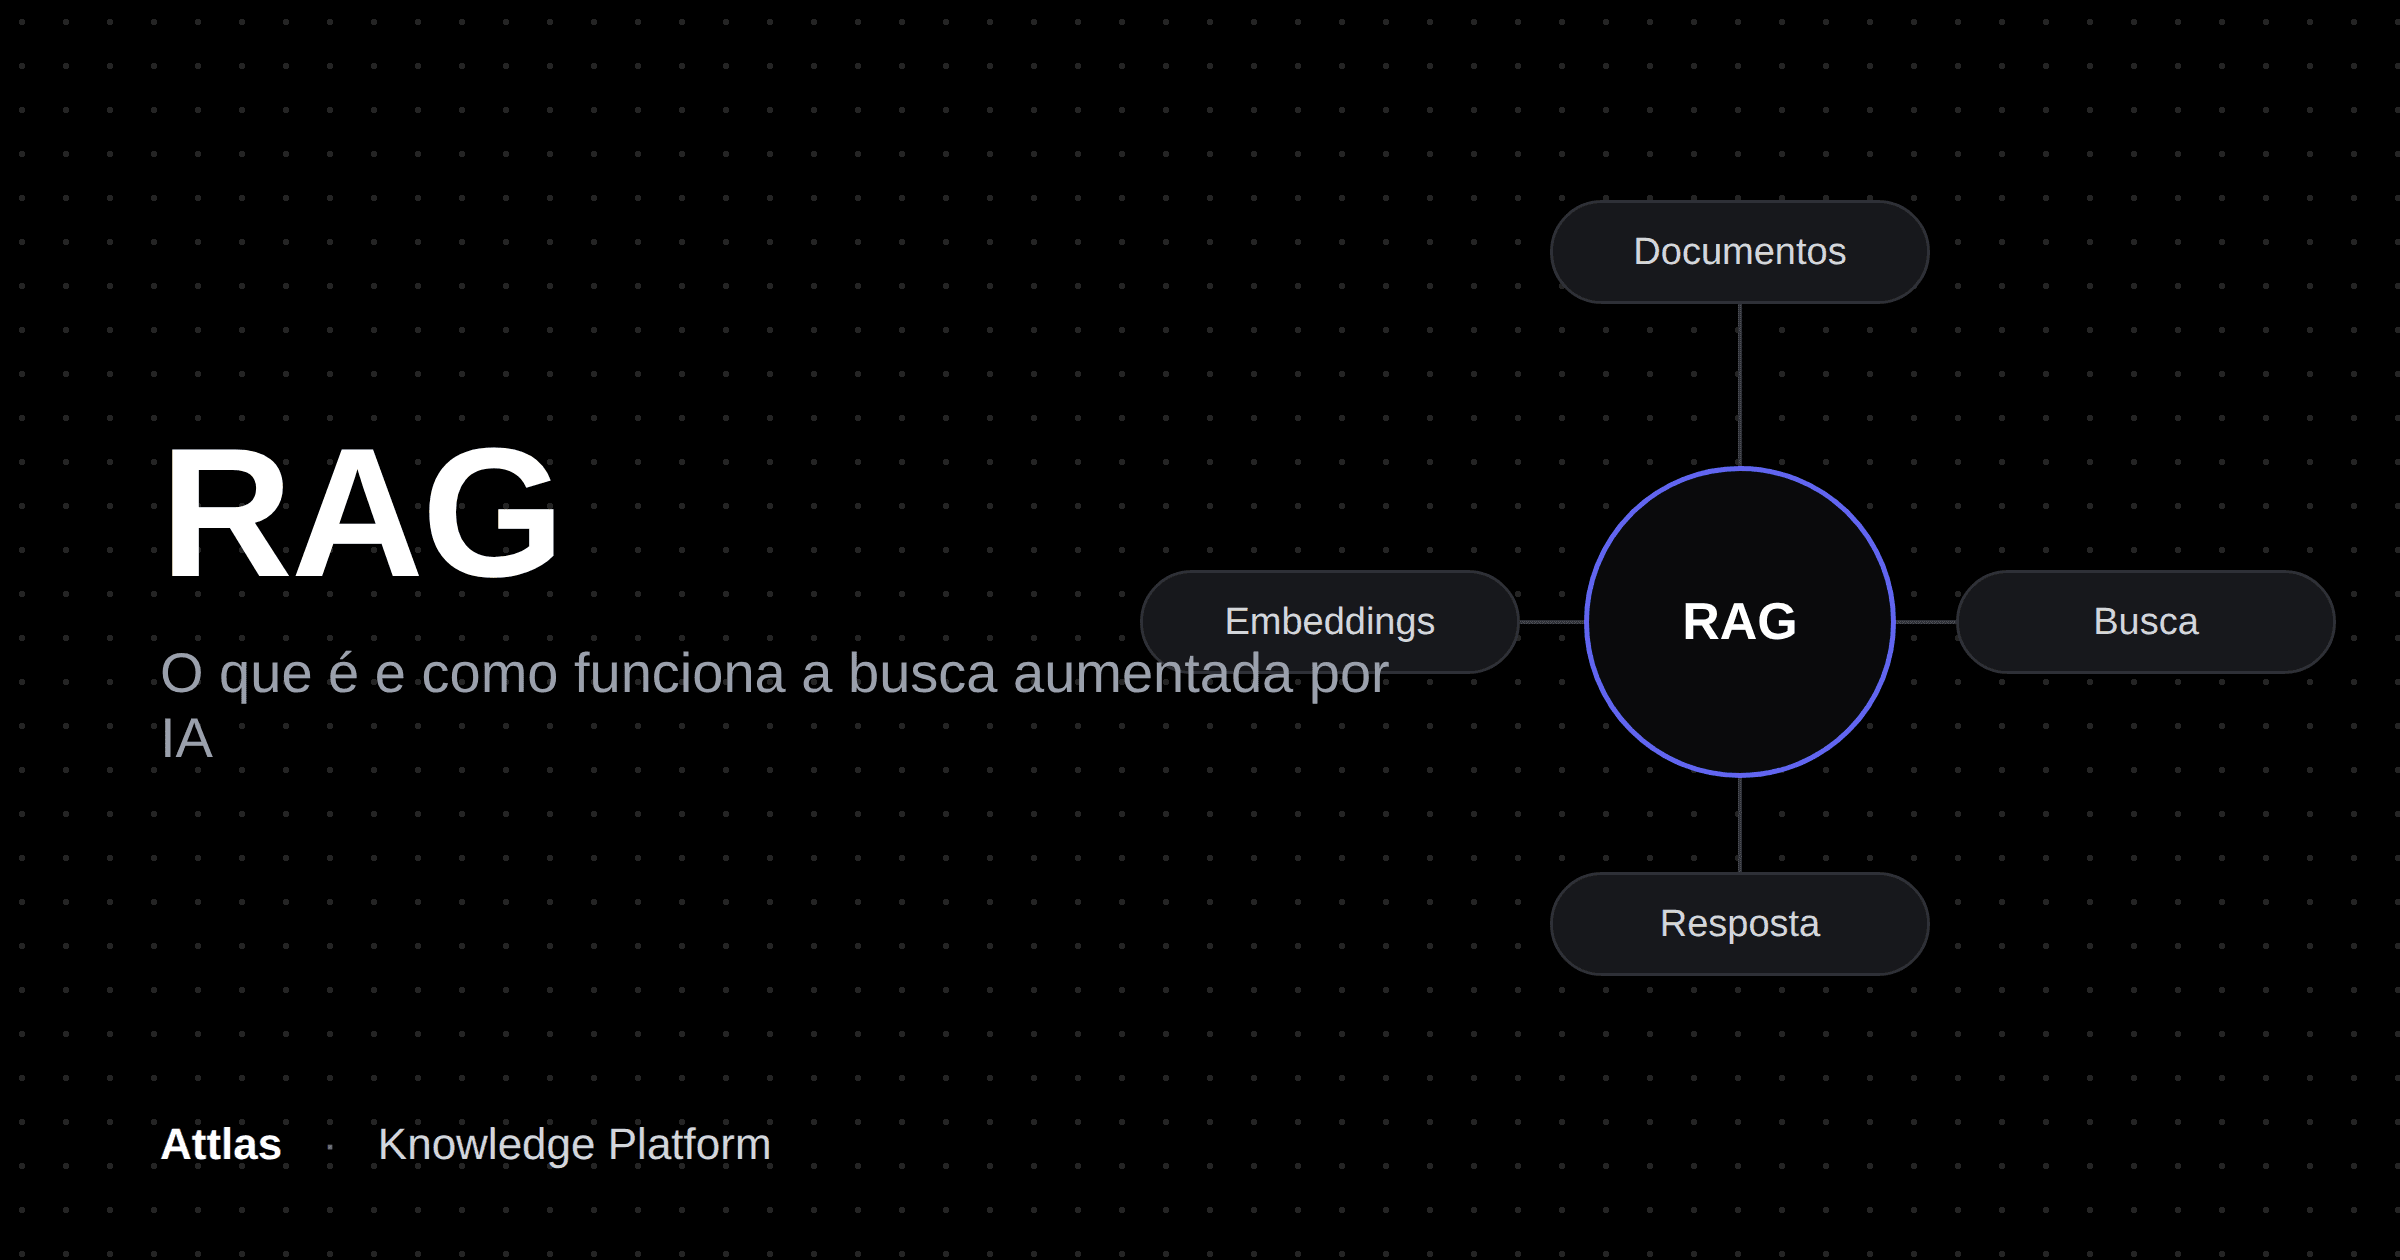
- O fluxo tem quatro etapas: indexação (chunks + embeddings), busca semântica, recuperação dos trechos mais relevantes e geração da resposta com base neles.
- RAG não substitui uma janela de contexto grande: ele filtra o que entra nela, o que costuma dar resultado melhor e mais barato do que colar tudo de uma vez.
- Diferente de fine-tuning, o RAG não altera o modelo: atualiza-se a base indexada, e a próxima busca já reflete a mudança, sem retreinar nada.
RAG (Retrieval-Augmented Generation, ou geração aumentada por recuperação) é a técnica que faz um modelo de IA buscar informação relevante numa base de conhecimento antes de responder, em vez de depender só do que aprendeu durante o treinamento. Na prática, é o que permite que um assistente cite a documentação real da sua empresa em vez de inventar uma resposta plausível.
Este guia é para quem já ouviu falar de RAG mas quer entender o que a sigla significa de fato, como o processo de busca e geração funciona por trás dos panos, e por que essa técnica é diferente de simplesmente aumentar a janela de contexto de um modelo.
O que é RAG
RAG é a combinação de dois passos: primeiro um sistema de busca recupera os trechos de texto mais relevantes para a pergunta feita, dentro de uma base de documentos; depois um modelo de linguagem usa esses trechos como referência para gerar uma resposta. O nome descreve exatamente isso: recuperação (retrieval) seguida de geração aumentada (augmented generation) por esse material recuperado.
A ideia central é simples: em vez de perguntar tudo direto ao modelo e confiar no que ele memorizou durante o treinamento, você entrega a ele o material certo, no momento certo, para que a resposta seja fundamentada em uma fonte real.
Como o RAG funciona na prática
O fluxo típico de um sistema de RAG segue algumas etapas:
- Indexação: documentos são divididos em pedaços menores (chunks) e convertidos em vetores numéricos que representam seu significado, um processo chamado de embedding.
- Busca semântica: quando alguém faz uma pergunta, ela também é convertida em vetor, e o sistema busca os chunks mais próximos semanticamente, não apenas por palavras-chave iguais.
- Recuperação: os trechos mais relevantes encontrados são selecionados para entrar no contexto da resposta.
- Geração: o modelo de linguagem recebe a pergunta original junto com esses trechos e gera uma resposta fundamentada neles, muitas vezes citando a fonte.
Cada trecho recuperado consome parte da janela de contexto do modelo, medida em tokens. Por isso a etapa de busca precisa ser seletiva: trazer só o que é relevante, não o documento inteiro.
RAG não é o mesmo que aumentar a janela de contexto
É tentador achar que, com janelas de contexto cada vez maiores, dá para simplesmente colar toda a base de conhecimento numa conversa e dispensar o RAG. Na prática, isso esbarra em dois problemas: custo, já que processar mais tokens sai mais caro e mais lento, e precisão, porque informação em excesso dentro de uma janela muito longa tende a receber menos atenção do modelo.
O RAG resolve isso na raiz: em vez de depender de uma janela gigante, ele filtra antes, trazendo só os trechos relevantes para aquela pergunta específica. Uma base de conhecimento bem indexada costuma superar uma janela de contexto enorme e mal filtrada.
RAG x fine-tuning: qual a diferença
Fine-tuning é retreinar (ou ajustar) os parâmetros internos de um modelo com um conjunto de dados específico, o que muda o comportamento do modelo de forma permanente. RAG não altera o modelo em nada: ele apenas fornece contexto externo no momento da pergunta, buscado em uma base que pode ser atualizada a qualquer momento, sem precisar retreinar nada.
Isso torna o RAG mais prático para conhecimento que muda com frequência, como documentação interna, políticas da empresa ou catálogos de produto: basta atualizar a base indexada, e a próxima busca já reflete a mudança.
Onde o RAG aparece no dia a dia
RAG é a técnica por trás de assistentes de IA que respondem com base em documentação real de uma empresa, em vez de conhecimento genérico da internet. Também costuma aparecer combinado com skills: uma skill pode descrever o processo, e o RAG entra para buscar o dado específico (um número, uma cláusula de contrato, uma política) necessário para executar aquele processo corretamente.
Perguntas frequentes
RAG elimina completamente as alucinações de um modelo de IA?
Não elimina por completo, mas reduz bastante, porque a resposta passa a ser fundamentada em trechos reais recuperados, em vez de depender só da memória do modelo.
Preciso de um banco de dados vetorial para fazer RAG?
É a abordagem mais comum hoje, já que a busca semântica depende de comparar vetores de embedding, mas o conceito de RAG em si é mais amplo do que uma tecnologia específica de armazenamento.
RAG funciona com qualquer tipo de documento?
A maioria dos formatos de texto pode ser indexada (PDF, Markdown, código, planilhas), desde que passem pelo processo de divisão em chunks e geração de embeddings antes da busca.
Conclusão
RAG existe para resolver um problema simples de enunciar e difícil de ignorar: um modelo de IA só responde bem sobre aquilo que consegue enxergar no momento da pergunta. Buscar o trecho certo antes de gerar a resposta é o que transforma um modelo genérico em um assistente que fala com propriedade sobre o seu negócio.
Leve contexto ao time e aos agentes
Base viva, wiki, chat e artefatos — e o mesmo conhecimento exposto via MCP.