
IA multimodal: o que é e como funciona
Entenda o que é IA multimodal, como modelos processam texto, imagem, áudio e vídeo juntos, onde são usados e quais são os limites.
Resumo rápido
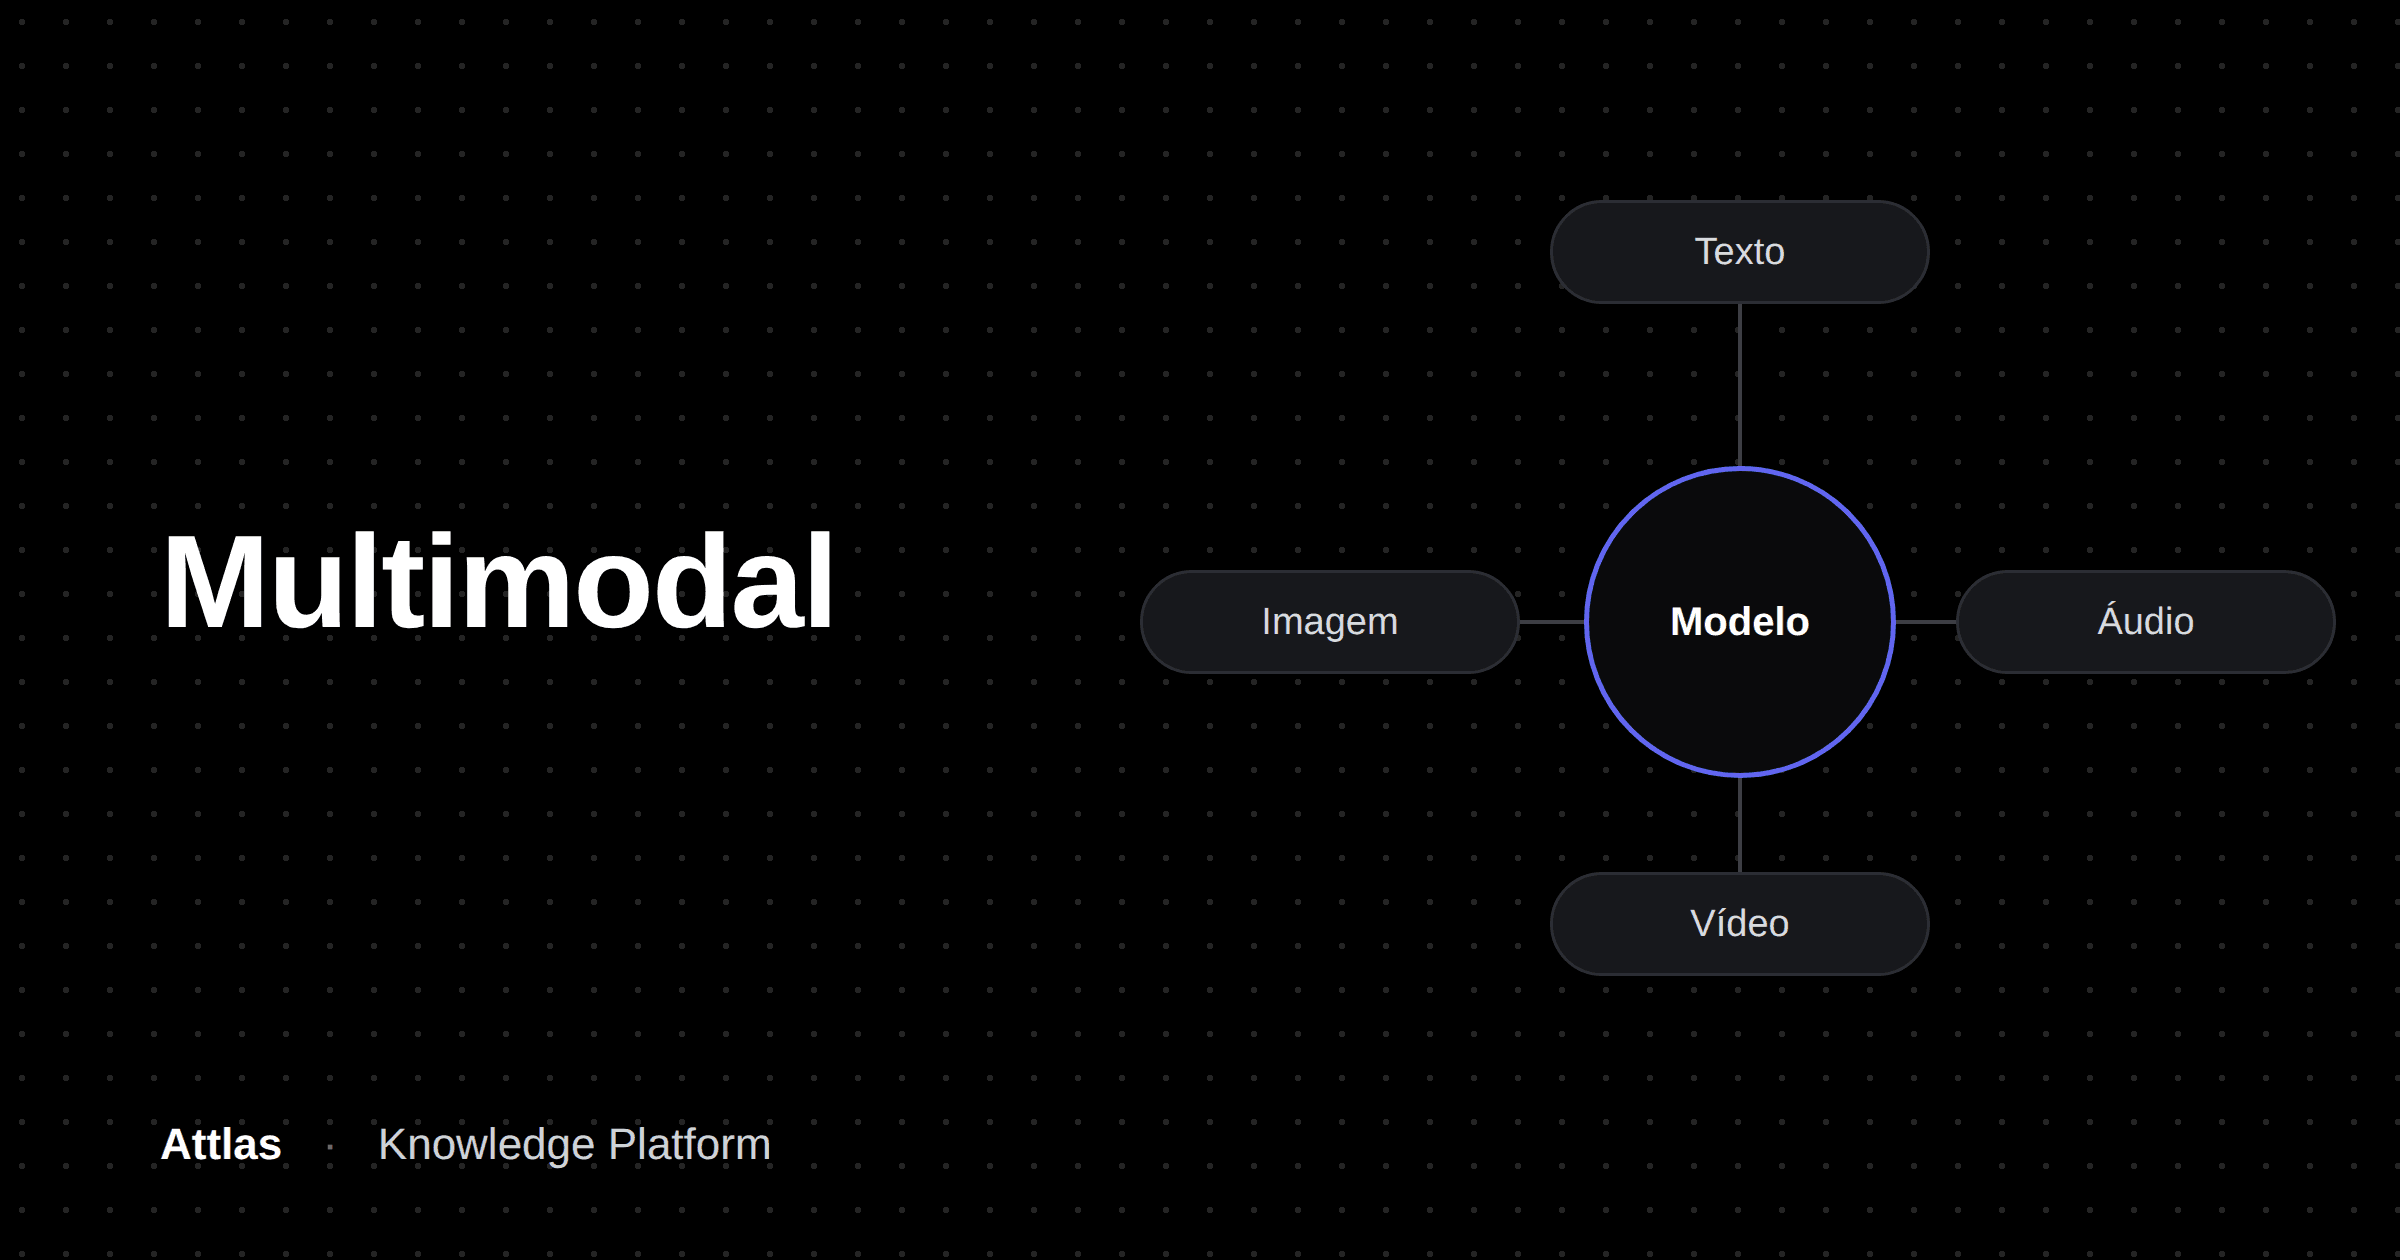
- IA multimodal processa mais de um tipo de dado, como texto, imagem, áudio e vídeo, no mesmo modelo.
- Cada modalidade é convertida em representações numéricas que o modelo consegue relacionar entre si.
- Amplia o que agentes de IA conseguem fazer, como interpretar prints, documentos e áudios.
- Tem limites: mais custo, consumo de contexto e risco de erro de interpretação em detalhes.
IA multimodal é um modelo capaz de receber e processar mais de um tipo de dado ao mesmo tempo, como texto, imagem, áudio e vídeo, em vez de lidar apenas com texto. Na prática, isso permite perguntar sobre uma foto, pedir a transcrição de um áudio ou analisar um gráfico dentro de um documento usando o mesmo modelo.
Este guia explica o que significa multimodal, como esses modelos funcionam por dentro, onde são usados e quais são seus limites, partindo do que já sabemos sobre LLMs.
O que é uma IA multimodal
"Modal" se refere ao tipo de dado: texto é uma modalidade, imagem é outra, áudio é outra. Um modelo unimodal trabalha com apenas uma delas. Um modelo multimodal aceita duas ou mais como entrada, produz duas ou mais como saída, ou ambos. Uma LLM tradicional recebe texto e devolve texto; um modelo multimodal pode receber uma imagem junto com uma pergunta escrita e responder em texto, ou receber um áudio e devolver uma transcrição.
Como funciona um modelo multimodal
O desafio central é que texto, imagem e áudio têm formatos completamente diferentes. A solução comum é converter cada modalidade em uma representação numérica que o modelo consiga processar em conjunto. Essa representação são os embeddings: uma imagem é transformada em vetores, um áudio é transformado em vetores, e o texto também. Quando tudo vive no mesmo espaço numérico, o modelo consegue relacionar o que aparece em uma foto com o que está escrito na pergunta.
No caso do texto, a entrada é dividida em tokens. Imagens e áudios também são convertidos em sequências de unidades que o modelo lê de forma parecida, e por isso uma imagem enviada ao modelo ocupa espaço na janela de contexto da mesma forma que o texto ocupa.
Exemplos de uso
- Imagem e texto: descrever uma foto, extrair informações de um print, ler um gráfico ou um documento escaneado.
- Áudio e texto: transcrever reuniões, resumir uma conversa gravada ou responder por voz.
- Vídeo: resumir o conteúdo de um vídeo ou localizar um momento específico nele.
- Geração: criar imagens, áudio ou vídeo a partir de uma descrição escrita.
Multimodal e agentes de IA
Modelos multimodais ampliam o que um agente de IA consegue fazer. Um agente que só lê texto depende de que alguém descreva a tela ou o documento; um agente multimodal pode olhar um print de erro, interpretar uma imagem anexada ou entender um áudio sem etapas de conversão manual.
Limites da IA multimodal
- Custo e tamanho: imagens, áudios e vídeos geram muito mais dados que texto, o que aumenta o custo e o consumo de contexto.
- Erros de interpretação: o modelo pode descrever algo que não está na imagem ou ler errado um detalhe pequeno, como um número em um gráfico.
- Cobertura desigual: nem todo modelo aceita todas as modalidades. É preciso conferir quais tipos de entrada e saída cada um suporta.
Perguntas frequentes
Multimodal é a mesma coisa que ter vários modelos juntos?
Não necessariamente. Um sistema pode encadear modelos separados, um para transcrever áudio e outro para responder. Um modelo multimodal nativo processa as diferentes modalidades dentro de uma única arquitetura.
Um modelo multimodal precisa gerar imagens?
Não. Muitos modelos multimodais apenas entendem imagens e áudio como entrada e respondem em texto. Gerar imagens ou áudio é uma capacidade adicional.
Multimodal substitui os modelos só de texto?
Não. Para tarefas puramente textuais, um modelo de texto continua sendo suficiente e costuma ser mais barato. Multimodal faz diferença quando a informação relevante não está só em texto.
Conclusão
Multimodal significa que a IA deixa de depender apenas de texto e passa a entender também imagem, áudio e vídeo dentro do mesmo modelo. Isso aproxima a IA de como as pessoas trabalham com informação no dia a dia, que raramente vem em um único formato.
Leve contexto ao time e aos agentes
Base viva, wiki, chat e artefatos — e o mesmo conhecimento exposto via MCP.